
PulseCheck · Infraestructura / SaaS interno
Monitoreo de SLA, uptime e incidentes en un solo panel
Panel operacional que sigue el estado de servicios críticos en vivo, calcula cumplimiento de SLA y centraliza la gestión de incidentes.
Probar demo en vivo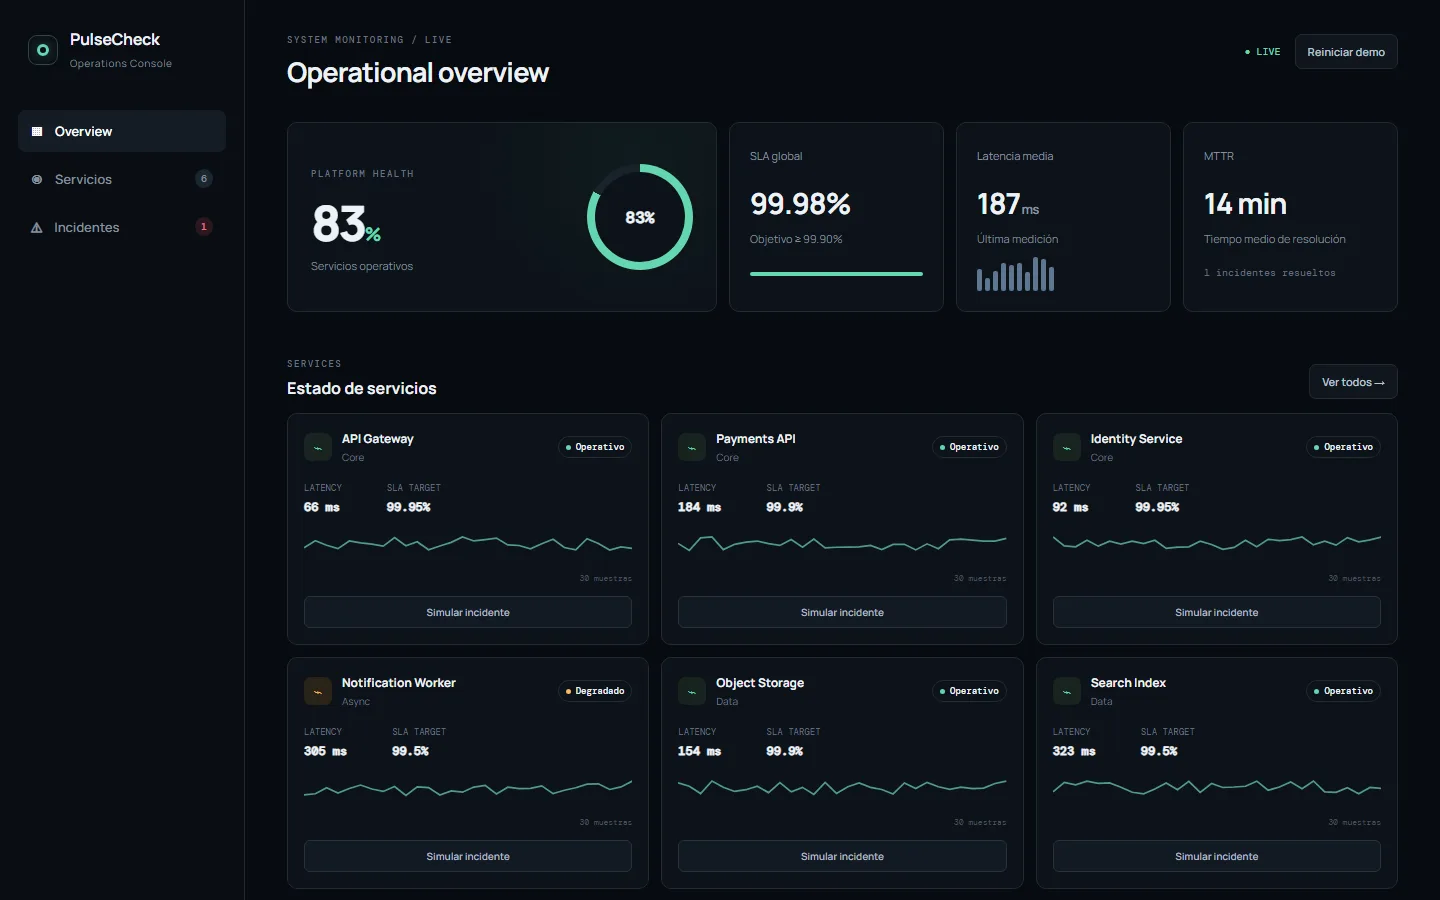
Contexto
Cuando el estado de los servicios críticos no está centralizado, un incidente se detecta tarde — por un ticket de usuario, no por monitoreo propio. Y sin métricas de SLA a la vista, es difícil saber si el compromiso operativo se está cumpliendo.
Qué construimos
Un dashboard operacional con seis servicios de ejemplo, cada uno con su uptime, latencia y objetivo de SLA. Permite simular degradaciones y caídas, crear y resolver incidentes, y ver en tiempo real cómo cada evento afecta el SLA global y el MTTR (tiempo medio de resolución).
Decisiones de arquitectura
Sin base de datos ni servicios externos: el reloj y los incidentes son simulados para que el dashboard se vea activo en cualquier momento que se abra. En una implementación real, la misma capa de visualización y cálculo de SLA se conecta a las métricas reales de infraestructura (Prometheus, health checks propios, etc.).
Pruébala
Entra al dashboard y presiona “Simular incidente” sobre cualquier servicio — verás el estado, uptime, latencia e incidentes activos cambiar en vivo. Después resuélvelo y observa cómo se recalculan la duración y el SLA.
Cómo empezar